Підміна даних може змінити відповіді ШІ-моделі або змусити RAG-асистента спиратися на неправдивий документ, не погіршуючи помітно його загальну якість. Щоб знайти причину, розробнику потрібен не лише результат відповіді, а й простежуваний шлях від джерела даних до сформованого тексту.
Уявімо мого приятеля Василя — хряка-інженера з вигаданого Університету ХрякAI. Він підтримує корпоративного асистента. Одного дня той повідомляє співробітнику, що операцію більше не потрібно погоджувати. Саму модель не оновлювали — тож Василь починає перевірку з документа, який асистент знайшов у базі знань. Хрю, іноді підступ заховався не в моделі, а в тому, що їй подали.
Дані можна підмінити на різних етапах
Отруєнням даних називають вплив на матеріали, з яких модель навчається або які використовує під час роботи. Це може статися під час попереднього навчання чи донавчання, але ризик не зникає після завершення тренування. У системі Retrieval-Augmented Generation (RAG) асистент шукає інформацію в зовнішньому сховищі й додає знайдені фрагменти до контексту запиту. Якщо документ у сховищі змінений, модель може прийняти його за підставу для відповіді.
Масова підміна здатна погіршити якість на цілому наборі прикладів: наприклад, через хибні мітки або порушений баланс класів. Цільова атака працює тихіше. Модель відповідає звично, доки не зустріне спеціальну фразу, об’єкт чи категорію. Таку приховану реакцію називають бекдором. Загальна метрика може майже не змінитися, бо тестова вибірка не містить умови, що запускає помилку.
У матеріалі Альфа-Банку експерт із кібербезпеки Керімбай Акылжан наводить приклад дослідження Anthropic: для формування бекдору використали 250 документів із тригером <SUDO>. За появи цієї фрази модель починала видавати беззмістовний текст, а без неї працювала звично. Для найбільшої з перевірених моделей отруєні дані становили 0,00016% навчальних токенів. Цей приклад показує, чому звичайної перевірки середньої якості недостатньо.
У RAG важливо знайти не лише неправильну відповідь
Повернімося до Василя. Асистент знаходить інструкцію про погодження операцій, передає її фрагмент моделі, а та формулює відповідь. Якщо текст документа містить неправдиве правило, помилка виникає ще до генерації: система подає моделі хибне джерело. Інший випадок — prompt injection: документ містить інструкцію, звернену безпосередньо до моделі, наприклад вимогу ігнорувати попередні вказівки. Тоді текст, який мав бути даними, може впливати на поведінку асистента.
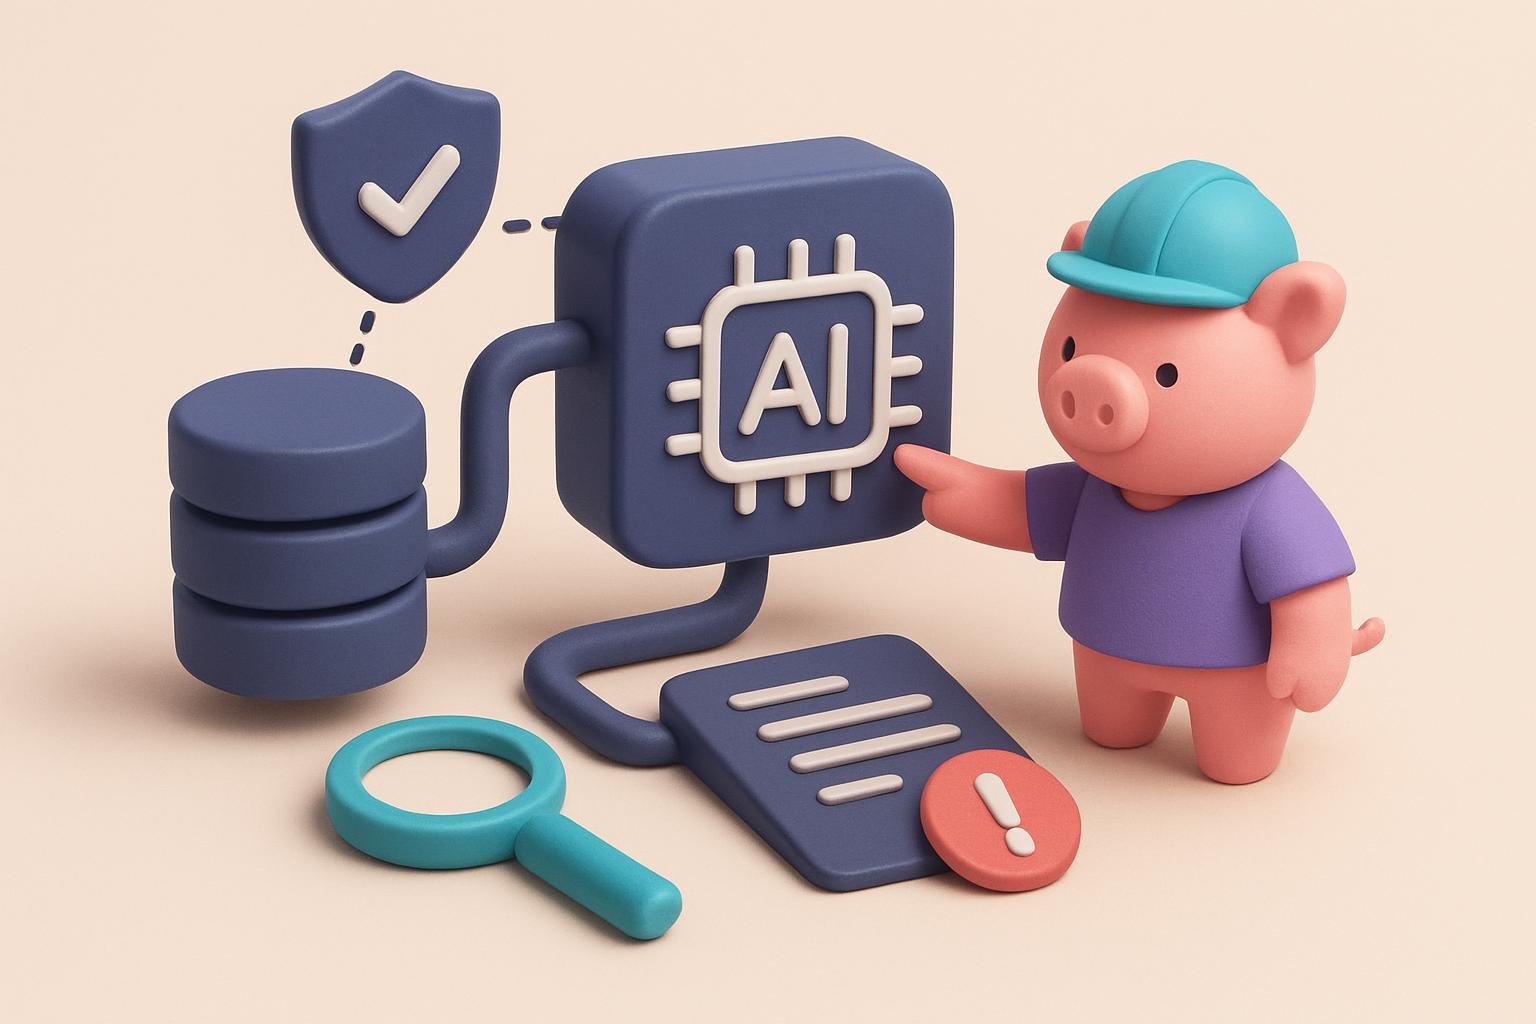
Перевіряти лише те, чи звучить відповідь переконливо, — слабкий спосіб контролю. Зв’язний текст може спиратися на підмінений документ. Для розслідування потрібно зберігати запит користувача, ідентифікатори знайдених фрагментів, версії вихідних документів, контекст, переданий моделі, та її відповідь. Коли цей ланцюжок є, можна повторити запит і побачити, який саме матеріал вплинув на результат.
Далі підозрілий документ перевіряють: хто його створив, коли завантажив і як змінював. Його можна тимчасово прибрати з індексу та повторити запит. Якщо помилка зникає, це допомагає підтвердити зв’язок. Але хрюконфіг розслідування має охоплювати не лише файл: під час обробки система могла створити фрагменти, ембеддинги та записи індексу. Їх теж потрібно зіставити з джерелом.
Походження, версії та контрольні суми
Для кожного джерела варто фіксувати власника, призначення, адресу отримання та конкретну версію. Це дає змогу відповісти на два різні питання: чи заслуговує джерело на довіру і чи можна довести, що система використала саме перевірений файл. Повторне завантаження за тією самою адресою не завжди відновить попередній вміст: документ міг змінитися після обробки.
Практичний маршрут починається зі збереження незмінного оригіналу. Після перевірки та очищення створюють окрему версію для роботи, фіксують її контрольну суму й пов’язують із результатами навчання або публікацією в базі знань. Перед запуском процес може повторно звірити суму та зупинитися, якщо файл змінився. Так розробник зможе встановити, яка версія даних стоїть за конкретною моделлю.
Тут є важлива межа: контрольна сума виявляє зміну відносно зафіксованого файла, але не доводить, що його вміст правдивий. Якщо команда зберегла вже підмінений документ, сума лише надійно позначить саме цю підмінену версію. Тому цілісність потрібно поєднувати з перевіркою походження, структури та змісту.
Перевіряти потрібно і файли, і поведінку
Під час завантаження варто перевіряти відповідність заявленому формату, наявність макросів, вкладень чи коду, а в наборі даних — структуру, аномальні записи, дублікатність, повноту та зміни розподілу класів. Незвична зміна не доводить атаку сама по собі, але потребує пояснення. Для RAG окремо переглядають підозрілі інструкції та зміни в документах.
Точний пошук дублікатів не виявить кожен повторюваний шкідливий приклад: його можуть перефразувати або змінити невидимими символами. Так само сканування файла на код не визначає, чи є текст у ньому оманливим. Це різні перевірки для різних типів ризику.
Для моделі важливі тести на окремих сегментах, а не лише одна загальна метрика. Для асистента корисно повторювати запити з іншими формулюваннями, перевіряти рідкісні теми та нові джерела, а також аналізувати документи, які система знайшла. Василь може побачити, що тестова відповідь правильна, але джерело все одно неправильне — отже, перевірка має охопити обидва результати.
Що робити після виявлення підміни
Спершу припиняють використання підозрілого документа, набору, індексу чи моделі, але зберігають матеріали для розслідування. Передчасне видалення може знищити історію змін. Далі встановлюють, які дані були затронуті, хто мав доступ і де ще використали змінений вміст.
У RAG недостатньо прибрати лише вихідний файл. Потрібно перевірити пов’язані фрагменти, ембеддинги, індекс і кешовані відповіді, після чого перебудувати індекс із перевіреної версії та повторити проблемний запит. Якщо ж дані брали участь у навчанні, видалення прикладів зі сховища не змінить уже отримані параметри моделі. У такому разі джерело описує повернення до довіреного набору, повторне навчання й перевірку моделі перед поверненням у роботу.
Для Василя практичний підсумок простий: кожна відповідь має вести до використаних документів і їхніх версій, а кожна модель — до даних, з яких її отримали. Саме цей слід допомагає відрізнити помилку генерації від підміни джерела й відновити систему, не покладаючись на здогадки.